FrenchTech SAAS
33.5K views | +5 today
 
Scooped by Mickael Ruau
onto FrenchTech SAAS
April 11, 2015 12:23 PM
Scoop.it!

HIBERNATE - Relational Persistence for Idiomatic Java

Table of Contents

Preface
1. Tutorial
1.1. Part 1 - The first Hibernate Application
1.1.1. Setup
1.1.2. The first class
1.1.3. The mapping file
1.1.4. Hibernate configuration
1.1.5. Building with Maven
1.1.6. Startup and helpers
1.1.7. Loading and storing objects
1.2. Part 2 - Mapping associations
1.2.1. Mapping the Person class
1.2.2. A unidirectional Set-based association
1.2.3. Working the association
1.2.4. Collection of values
1.2.5. Bi-directional associations
1.2.6. Working bi-directional links
1.3. Part 3 - The EventManager web application
1.3.1. Writing the basic servlet
1.3.2. Processing and rendering
1.3.3. Deploying and testing
1.4. Summary
2. Architecture
2.1. Overview
2.1.1. Minimal architecture
2.1.2. Comprehensive architecture
2.1.3. Basic APIs
2.2. Contextual sessions
3. Configuration
3.1. Programmatic configuration
3.2. Obtaining a SessionFactory
3.3. JDBC connections
3.4. Optional configuration properties
3.4.1. SQL Dialects
3.4.2. Outer Join Fetching
3.4.3. Binary Streams
3.4.4. Second-level and query cache
3.4.5. Query Language Substitution
3.4.6. Hibernate statistics
3.5. Logging
3.6. Implementing a NamingStrategy
3.7. Implementing a PersisterClassProvider
3.8. XML configuration file
3.9. Java EE Application Server integration
3.9.1. Transaction strategy configuration
3.9.2. JNDI-bound SessionFactory
3.9.3. Current Session context management with JTA
4. Persistent Classes
4.1. A simple POJO example
4.1.1. Implement a no-argument constructor
4.1.2. Provide an identifier property
4.1.3. Prefer non-final classes (semi-optional)
4.1.4. Declare accessors and mutators for persistent fields (optional)
4.2. Implementing inheritance
4.3. Implementing equals() and hashCode()
4.4. Dynamic models
4.5. Tuplizers
4.6. EntityNameResolvers
5. Basic O/R Mapping
5.1. Mapping declaration
5.1.1. Entity
5.1.2. Identifiers
5.1.3. Optimistic locking properties (optional)
5.1.4. Property
5.1.5. Embedded objects (aka components)
5.1.6. Inheritance strategy
5.1.7. Mapping one to one and one to many associations
5.1.8. Natural-id
5.1.9. Any
5.1.10. Properties
5.1.11. Some hbm.xml specificities
5.2. Hibernate types
5.2.1. Entities and values
5.2.2. Basic value types
5.2.3. Custom value types
5.3. Mapping a class more than once
5.4. SQL quoted identifiers
5.5. Generated properties
5.6. Column transformers: read and write expressions
5.7. Auxiliary database objects
6. Types
6.1. Value types
6.1.1. Basic value types
6.1.2. Composite types
6.1.3. Collection types
6.2. Entity types
6.3. Significance of type categories
6.4. Custom types
6.4.1. Custom types using org.hibernate.type.Type
6.4.2. Custom types using org.hibernate.usertype.UserType
6.4.3. Custom types using org.hibernate.usertype.CompositeUserType
6.5. Type registry
7. Collection mapping
7.1. Persistent collections
7.2. How to map collections
7.2.1. Collection foreign keys
7.2.2. Indexed collections
7.2.3. Collections of basic types and embeddable objects
7.3. Advanced collection mappings
7.3.1. Sorted collections
7.3.2. Bidirectional associations
7.3.3. Bidirectional associations with indexed collections
7.3.4. Ternary associations
7.3.5. Using an
7.4. Collection examples
8. Association Mappings
8.1. Introduction
8.2. Unidirectional associations
8.2.1. Many-to-one
8.2.2. One-to-one
8.2.3. One-to-many
8.3. Unidirectional associations with join tables
8.3.1. One-to-many
8.3.2. Many-to-one
8.3.3. One-to-one
8.3.4. Many-to-many
8.4. Bidirectional associations
8.4.1. one-to-many / many-to-one
8.4.2. One-to-one
8.5. Bidirectional associations with join tables
8.5.1. one-to-many / many-to-one
8.5.2. one to one
8.5.3. Many-to-many
8.6. More complex association mappings
9. Component Mapping
9.1. Dependent objects
9.2. Collections of dependent objects
9.3. Components as Map indices
9.4. Components as composite identifiers
9.5. Dynamic components
10. Inheritance mapping
10.1. The three strategies
10.1.1. Table per class hierarchy
10.1.2. Table per subclass
10.1.3. Table per subclass: using a discriminator
10.1.4. Mixing table per class hierarchy with table per subclass
10.1.5. Table per concrete class
10.1.6. Table per concrete class using implicit polymorphism
10.1.7. Mixing implicit polymorphism with other inheritance mappings
10.2. Limitations
11. Working with objects
11.1. Hibernate object states
11.2. Making objects persistent
11.3. Loading an object
11.4. Querying
11.4.1. Executing queries
11.4.2. Filtering collections
11.4.3. Criteria queries
11.4.4. Queries in native SQL
11.5. Modifying persistent objects
11.6. Modifying detached objects
11.7. Automatic state detection
11.8. Deleting persistent objects
11.9. Replicating object between two different datastores
11.10. Flushing the Session
11.11. Transitive persistence
11.12. Using metadata
12. Read-only entities
12.1. Making persistent entities read-only
12.1.1. Entities of immutable classes
12.1.2. Loading persistent entities as read-only
12.1.3. Loading read-only entities from an HQL query/criteria
12.1.4. Making a persistent entity read-only
12.2. Read-only affect on property type
12.2.1. Simple properties
12.2.2. Unidirectional associations
12.2.3. Bidirectional associations
13. Transactions and Concurrency
13.1. Session and transaction scopes
13.1.1. Unit of work
13.1.2. Long conversations
13.1.3. Considering object identity
13.1.4. Common issues
13.2. Database transaction demarcation
13.2.1. Non-managed environment
13.2.2. Using JTA
13.2.3. Exception handling
13.2.4. Transaction timeout
13.3. Optimistic concurrency control
13.3.1. Application version checking
13.3.2. Extended session and automatic versioning
13.3.3. Detached objects and automatic versioning
13.3.4. Customizing automatic versioning
13.4. Pessimistic locking
13.5. Connection release modes
14. Interceptors and events
14.1. Interceptors
14.2. Event system
14.3. Hibernate declarative security
15. Batch processing
15.1. Batch inserts
15.2. Batch updates
15.3. The StatelessSession interface
15.4. DML-style operations
16. HQL: The Hibernate Query Language
16.1. Case Sensitivity
16.2. The from clause
16.3. Associations and joins
16.4. Forms of join syntax
16.5. Referring to identifier property
16.6. The select clause
16.7. Aggregate functions
16.8. Polymorphic queries
16.9. The where clause
16.10. Expressions
16.11. The order by clause
16.12. The group by clause
16.13. Subqueries
16.14. HQL examples
16.15. Bulk update and delete
16.16. Tips & Tricks
16.17. Components
16.18. Row value constructor syntax
17. Criteria Queries
17.1. Creating a Criteria instance
17.2. Narrowing the result set
17.3. Ordering the results
17.4. Associations
17.5. Dynamic association fetching
17.6. Components
17.7. Collections
17.8. Example queries
17.9. Projections, aggregation and grouping
17.10. Detached queries and subqueries
17.11. Queries by natural identifier
18. Native SQL
18.1. Using a SQLQuery
18.1.1. Scalar queries
18.1.2. Entity queries
18.1.3. Handling associations and collections
18.1.4. Returning multiple entities
18.1.5. Returning non-managed entities
18.1.6. Handling inheritance
18.1.7. Parameters
18.2. Named SQL queries
18.2.1. Using return-property to explicitly specify column/alias names
18.2.2. Using stored procedures for querying
18.3. Custom SQL for create, update and delete
18.4. Custom SQL for loading
19. Filtering data
19.1. Hibernate filters
20. Improving performance
20.1. Fetching strategies
20.1.1. Working with lazy associations
20.1.2. Tuning fetch strategies
20.1.3. Single-ended association proxies
20.1.4. Initializing collections and proxies
20.1.5. Using batch fetching
20.1.6. Using subselect fetching
20.1.7. Fetch profiles
20.1.8. Using lazy property fetching
20.2. The Second Level Cache
20.2.1. Cache mappings
20.2.2. Strategy: read only
20.2.3. Strategy: read/write
20.2.4. Strategy: nonstrict read/write
20.2.5. Strategy: transactional
20.2.6. Cache-provider/concurrency-strategy compatibility
20.3. Managing the caches
20.4. The Query Cache
20.4.1. Enabling query caching
20.4.2. Query cache regions
20.5. Bytecode Enhancement
20.5.1. Implementing org.hibernate.engine.spi.ManagedEntity interface
20.5.2. Runtime instrument
20.5.3. Build-time instrument
20.6. Understanding Collection performance
20.6.1. Taxonomy
20.6.2. Lists, maps, idbags and sets are the most efficient collections to update
20.6.3. Bags and lists are the most efficient inverse collections
20.6.4. One shot delete
20.7. Monitoring performance
20.7.1. Monitoring a SessionFactory
20.7.2. Metrics
21. Toolset Guide
21.1. Automatic schema generation
21.1.1. Customizing the schema
21.1.2. Running the tool
21.1.3. Properties
21.1.4. Using Ant
21.1.5. Incremental schema updates
21.1.6. Using Ant for incremental schema updates
21.1.7. Schema validation
21.1.8. Using Ant for schema validation
22. Additional modules
22.1. Bean Validation
22.1.1. Adding Bean Validation
22.1.2. Configuration
22.1.3. Catching violations
22.1.4. Database schema
22.2. Hibernate Search
22.2.1. Description
22.2.2. Integration with Hibernate Annotations
23. Example: Parent/Child
23.1. A note about collections
23.2. Bidirectional one-to-many
23.3. Cascading life cycle
23.4. Cascades and unsaved-value
23.5. Conclusion
24. Example: Weblog Application
24.1. Persistent Classes
24.2. Hibernate Mappings
24.3. Hibernate Code
25. Example: Various Mappings
25.1. Employer/Employee
25.2. Author/Work
25.3. Customer/Order/Product
25.4. Miscellaneous example mappings
25.4.1. "Typed" one-to-one association
25.4.2. Composite key example
25.4.3. Many-to-many with shared composite key attribute
25.4.4. Content based discrimination
25.4.5. Associations on alternate keys
26. Best Practices
27. Database Portability Considerations
27.1. Portability Basics
27.2. Dialect
27.3. Dialect resolution
27.4. Identifier generation
27.5. Database functions
27.6. Type mappings
References
No comment yet.
FrenchTech SAAS
Les news de l'univers SAAS et FrenchTech
Curated by Mickael Ruau
Your new post is loading...
Popular Tags

Rescooped by Mickael Ruau from DONNÉES DE SANTÉ : DE LA DONNÉE DISPONIBLE À L’INFORMATION UTILE
June 3, 2022 5:15 AM
Scoop.it!

Le nantais Octopize veut devenir le leader européen des données de synthèse

Le nantais Octopize veut devenir le leader européen des données de synthèse | FrenchTech SAAS | Scoop.it

La deep tech nantaise a développé une technologie unique d'anonymisation de données qu’elle déploie déjà sur le secteur de la santé. Si une collaboration vient d’être nouée avec le Health Data Hub pour démocratiser l’utilisation des données synthétique auprès des acteurs de ce marché, Octopize regarde aussi d’autres marchés.

Via Lionel Reichardt / le Pharmageek
No comment yet.
Scooped by Mickael Ruau
January 14, 2022 9:34 AM
Scoop.it!

Exploration de données — Wikipédia

Exploration de données - Wikipédia

L' exploration de données, connue aussi sous l'expression de fouille de données, forage de données, prospection de données, data mining , ou encore extraction de connaissances à partir de données, a pour objet l'extraction d'un savoir ou d'une connaissance à partir de grandes quantités de données, par des méthodes automatiques ou semi-automatiques.

No comment yet.
Scooped by Mickael Ruau
December 31, 2021 4:41 AM
Scoop.it!

2021: major technological advances to accelerate, democratize and certify AI uses

2021: major technological advances to accelerate, democratize and certify AI uses | FrenchTech SAAS | Scoop.it
In 2020, OVHcloud launched a portfolio of PaaS solutions dedicated to Data and AI. As an innovative cloud player for the past 20 years, our up-to-date technology coupled with our close collaboration with data science communities as well as the most cutting-edge players in the sector has enabled us to identify 10 strong AI trends … 2021: major technological advances to accelerate, democratize and certify AI uses Read More »
No comment yet.
Scooped by Mickael Ruau
December 27, 2021 1:39 AM
Scoop.it!

Explaining slow queries to my manager

Explaining slow queries to my manager | FrenchTech SAAS | Scoop.it
In our previous blog post about observability, we explained how to build a comprehensive view of how your SQL workloads behave, and the many reasons why it is important to have this view. In this blog post, we will take a closer look into the four types of SQL query, and how they can impact … Explaining slow queries to my manager Read More »
No comment yet.
Scooped by Mickael Ruau
December 25, 2021 11:53 AM
Scoop.it!

Best Practices for Configuring Optimal MySQL Memory Usage

Best Practices for Configuring Optimal MySQL Memory Usage | FrenchTech SAAS | Scoop.it
Percona's Peter Zaitsev discusses some of the best practices for configuring optimal MySQL memory usage.
No comment yet.
Scooped by Mickael Ruau
December 23, 2021 1:44 AM
Scoop.it!

Le programmateur d'évènements sous MySQL-

Le programmateur d'évènements sous MySQL- | FrenchTech SAAS | Scoop.it
Vous lirez beaucoup de traductions plus ou moins déformées de cette expression. Mot à mot « Event Scheduler » signifie programmateur d'évènements. Ce processus (interne au moteur) déclenche des évènements en fonction de la date et de l'heure auxquelles ils sont programmés. Ce sont donc des déclencheurs temporels (en anglais triggers) qui vont ordonner l'exécution de l'évènement. L'évènement réalise une combinaison de procédures stockées ou de une à plusieurs requêtes SQL programmées par l'utilisateur. Le déclenchement peut être périodique et se lancer de une à plusieurs fois.
No comment yet.
Scooped by Mickael Ruau
December 21, 2021 1:44 AM
Scoop.it!

Améliorer les performances(MySQL 5.1)

Améliorer les performances(MySQL 5.1) | FrenchTech SAAS | Scoop.it
Ce tutoriel est un cours pour vous apprendre à améliorer les performances grâce au partitionnement (MySQL 5.1)
No comment yet.
Scooped by Mickael Ruau
December 20, 2021 1:43 AM
Scoop.it!

Utilisation avancée des procédures stockées MySQL .

Utilisation avancée des procédures stockées MySQL . | FrenchTech SAAS | Scoop.it
Utilisation avancée des procédures stockées MySQL .
No comment yet.
Scooped by Mickael Ruau
December 16, 2021 1:48 AM
Scoop.it!

Jet Profiler pour MySQL

Jet Profiler pour MySQL | FrenchTech SAAS | Scoop.it
Jet Profiler de Polaricon est un outil permettant d'identifier des goulots de performance dans les bases MySQL. Il s'agit d'une application bureautique qui récolte une variété de statistiques d'une base de données en cours. Il est compatible avec Windows, Mac et Linux. MySQL étant habituellement associé aux sites web, Jet Profiler est donc utilisé plus souvent pour mesurer la performance des sites. Il peut être utilisé pour analyser la performance d'une application écrite pour MySQL.
No comment yet.
Scooped by Mickael Ruau
December 13, 2021 1:30 AM
Scoop.it!

Retour d'expérience sur la mise en oeuvre du BigData chez PagesJaunes.fr

Retour d'expérience sur la mise en oeuvre du BigData chez PagesJaunes.fr | FrenchTech SAAS | Scoop.it
Retour d'expérience sur la mise en oeuvre du BigData chez PagesJaunes.fr
No comment yet.
Scooped by Mickael Ruau
December 12, 2021 8:53 AM
Scoop.it!

RNVP adresses françaises, norme AFNOR NF 10-011 de l’adresses

Illustration règles normes françaises
Quelques règles de la norme de l'adresse française

Format de l'adresse :
6 lignes de 38 caractères maximum (éventuellement une 7ème ligne pour l’international, pour indiquer le pays).
Les lignes à blanc – non renseignées – sont supprimées pour rendre l’adresse plus esthétique.
L’adresse est alignée à gauche, ce qui facilite la lecture optique mécanisée des adresses par La Poste.
Caractères tolérés par la norme Afnor NF Z 10-011 :
A partir de la ligne 4 (numéro et libellé de la voie), aucune ponctuation, italique ou souligné qui perturbent la lecture automatique des adresses.
Par ailleurs, la norme veut que seule la dernière ligne soit en majuscule, mais La Poste recommande vivement une mise en majuscule des 3 dernières lignes adresses (voie / lieux-dits ou Boite Postale / Code Postal Commune), afin d’optimiser significativement la reconnaissance des adresses par les lecteurs optiques des centres de traitement de courriers.
Présentation de l’adresse selon la norme Afnor NF Z 10-011 :
Les éléments de l’adresse doivent être ordonnés selon une structure bien précise

Adresse B TO C après RNVP

1.Civilité - Titre ou Qualité - Prénom - Nom
2.N°APP ou Bal - étage - Couloir - Esc
3.Entrée - Bâtiment - Immeuble - Résidence
4.Numéro - Libellé de la voie
5.Lieu dit ou Service particulier de distribution
6.Code postal et Localité de destination
ou Code Cedex et Libellé Cedex

Adresse B TO B après RNVP

1. raison sociale ou dénomination
2. identité du destinataire et ou service
3. Entrée - Bâtiment - Immeuble - Rés - ZI
4. Numéro - Libellé de la voie
5. mention spéciale et commune géographique
6. Code postal et Localité de destination
ou Code Cedex et Libellé Cedex

Source SNA (Service National de l’Adresse – Groupe La Poste)
No comment yet.
Scooped by Mickael Ruau
December 9, 2021 4:40 AM
Scoop.it!

Deep Learning explained to my 8-year-old daughter

Deep Learning explained to my 8-year-old daughter | FrenchTech SAAS | Scoop.it
Machine Learning and especially Deep Learning are hot topics and you are sure to have come across the buzzword “Artificial Intelligence” in the media. Yet these are not new concepts. The first Artificial Neural Network (ANN) was introduced in the 40s. So why all the recent interest around neural networks and Deep Learning?  We will explore this … Deep Learning explained to my 8-year-old daughter Read More »
No comment yet.
Scooped by Mickael Ruau
December 8, 2021 1:55 AM
Scoop.it!

Redis : les bases de données vues autrement | Fonctionnement de ce SGBD - IONOS

Redis : les bases de données vues autrement | Fonctionnement de ce SGBD - IONOS | FrenchTech SAAS | Scoop.it
Le nom Redis vient de Remote Dictionary Server. Ce type de serveur est idéal lorsqu’il est utilisé comme mémoire de données rapide. Le système de gestion de base de données (SGBD) Redis propose également une base de données en mémoire et un système clé-valeur.

Base de données en mémoire : ces bases de données permettent au SGBD d’enregistrer toutes les données directement dans la mémoire vive. Ceci permet des délais d’accès très courts – même en cas de grands volumes de données non structurées.
Système clé-valeur : les bases de données clé-valeur séduisent par leur performance élevée et leur possibilité de mise à l’échelle grâce à une structure simple. Une clé permettant de consulter les informations a posteriori est créée pour chaque entrée.

Dans le cas d’un serveur Redis, toutes les données ne sont donc pas situées sur le disque dur, mais dans la mémoire vive. Du fait de ce choix, Redis est aussi bien une mémoire cache qu’une mémoire vive : Redis ne fait aucune distinction entre les informations stockées dans la base de données durablement ou uniquement à court terme.

Chaque entrée de la base de données se voit attribuer une clé. Elle permet de consulter les données ultérieurement en toute simplicité. Les entrées ne sont donc pas liées les unes aux autres et ne doivent donc pas être interrogées dans plusieurs tableaux. Les informations sont directement disponibles.

Du fait de l’enregistrement dans la mémoire vive, il existe toutefois un risque de perte de l’ensemble des données en cas de panne du serveur. Afin d’éviter cela, Redis peut soit dupliquer régulièrement toutes les données sur un disque dur de sauvegarde soit enregistrer toutes les commandes nécessaires à une reconstruction dans un fichier journal.
No comment yet.
Scooped by Mickael Ruau
February 28, 2022 6:38 AM
Scoop.it!

Apprendre comment interroger une base MariaDB depuis Oracle, un billet blog de CinePhil

Apprendre comment interroger une base MariaDB depuis Oracle, un billet blog de CinePhil | FrenchTech SAAS | Scoop.it
On trouve différents tutoriels, la plupart en anglais, au sujet de la création d'un database_link dans Oracle pour accéder à une base MySQL. L'un parle du cas spécifique de l'accès à une base MariaDB mais ses exemples de code m'ont posé quelques soucis de compréhension entraînant par la suite un refus de fonctionnement et quelques prises de tête pendant pas mal de temps.
Je vais donc décrire ici pas à pas ce qu'il faut faire pour que ça fonctionne.
No comment yet.
Scooped by Mickael Ruau
January 9, 2022 9:57 AM
Scoop.it!

Quelles perspectives au-delà du data warehouse ?

Quelles perspectives au-delà du data warehouse ? | FrenchTech SAAS | Scoop.it
L’entrepôt de données traditionnel arrive-t-il en fin de vie ? Dans l’affirmative, quelle solution hybride pourrait lui succéder ? Ces questionnements laissent apparaître plusieurs évolutions possibles du data warehousing et poussent les entreprises à choisir leur(s) voie(s).
No comment yet.
Scooped by Mickael Ruau
December 28, 2021 4:40 AM
Scoop.it!

Machine learning : from idea to reality

Machine learning : from idea to reality | FrenchTech SAAS | Scoop.it
where we explain machine learning concepts and how to get started using it, for real.
No comment yet.
Scooped by Mickael Ruau
December 26, 2021 8:56 AM
Scoop.it!

Normalisation adresse postale - Définitions Marketing » L'encyclopédie illustrée du marketing

Normalisation adresse postale - Définitions Marketing » L'encyclopédie illustrée du marketing | FrenchTech SAAS | Scoop.it


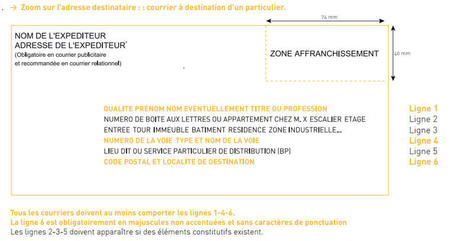
Ci-dessous les 6 règles d'or de la norme postale selon le SNA :

Source image : SNA

Dans un sens plus courant, la normalisation postale désigne l'opération qui consiste à vérifier et remettre à la norme postale les adresses d'un fichier avant une opération de marketing direct. Le but est alors de réduire les coûteux PND anciennement appelés NPAI et de bénéficier de tarifs postaux spécifiques. La normalisation postale se fait généralement dans le cadre d'un traitement dit traitement RNVP.

Un exemple de procédure de normalisation d'une adresse postale :


Source image : Cartégie
No comment yet.
Scooped by Mickael Ruau
December 23, 2021 1:45 AM
Scoop.it!

Utiliser XML dans MySQL 5.1 et 6.0.

Utiliser XML dans MySQL 5.1 et 6.0. | FrenchTech SAAS | Scoop.it
Dans cet article, nous discutons des fonctionnalités XML disponibles dans MySQL, avec l'accent sur les nouvelles fonctionnalités des versions 5.1 et 6.0.
Nous partons du principe que vous avez déjà des connaissances sur XML et que vous savez ce que les termes « valide » et « bien formé » veulent dire.
Nous supposons aussi que vous ayez quelques connaissances sur XPath.

Nous allons couvrir ces différents sujets :

les méthodes pour exporter des données MySQL dans le format XML, incluant l'utilisation de lib_MySQLudf_xql, une librairie tierce qui peut être utilisée pour cette tâche ;
l'utilisation des fonctions (nouvelles dans MySQL 5.1) ExtractValue() et UpdateXML() pour travailler avec XML et Xpath ;
le stockage de données depuis XML dans une base MySQL en utilisant la déclaration LOAD XML (implémentée dans MySQL 6.0) ;
quelques éléments de sécurités à garder à l'esprit quand on utilise ces techniques
No comment yet.
Scooped by Mickael Ruau
December 22, 2021 1:49 AM
Scoop.it!

La gestion des erreurs en SQL procédural avec MySQL.

La gestion des erreurs en SQL procédural avec MySQL. | FrenchTech SAAS | Scoop.it
Depuis la version 5, MySQL supporte la programmation intégrée (ou SQL procédural), qui permet de le rendre très autonome. Nous verrons dans cet article quelles sont les possibilités qui s'offrent à nous pour reporter la programmation sur le SGBD. Je ne prétends pas aborder toutes les possibilités du SQL procédural, mais seulement proposer une des très nombreuses utilisations que l'on peut en faire. Ce tutoriel peut constituer une introduction au SQL procédural pour les débutants, et une solution efficace de gestion d'erreurs pour les plus confirmés. ♪
No comment yet.
Scooped by Mickael Ruau
December 20, 2021 1:44 AM
Scoop.it!

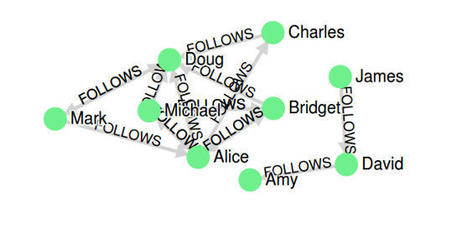
Preview of the Neo4j Graph Data Science plugin with examples from the “Graph Algorithms: Practical Examples in Apache Spark and Neo4j” book | by Tomaz Bratanic | Towards Data Science

Preview of the Neo4j Graph Data Science plugin with examples from the “Graph Algorithms: Practical Examples in Apache Spark and Neo4j” book | by Tomaz Bratanic | Towards Data Science | FrenchTech SAAS | Scoop.it
In the past couple of years, the field of data science has gained much traction. It has become an essential part of business and academic research. Combined with the increasing popularity of graphs…
Mickael Ruau's insight:

his post converts examples from the O’Reilly book using the new syntax in the Neo4j Graph Data Science (GDS) Library, available here.

No comment yet.
Scooped by Mickael Ruau
December 20, 2021 1:42 AM
Scoop.it!

O'Reilly Graph Algorithm Examples in Apache Spark & Neo4j Book

O'Reilly Graph Algorithm Examples in Apache Spark & Neo4j Book | FrenchTech SAAS | Scoop.it


Read this book to:
Register to Download O'Reilly's Graph Algorithms for Free!

Learn how graph analytics vary from conventional statistical analysis
Understand how classic graph algorithms work and how they are applied
Dive into popular algorithms like PageRank, Label Propagation and Louvain to find out how subtle parameters impact results
Get guidance on which algorithms to use for different types of questions
Explore algorithm examples with working code and sample datasets for both Apache Spark and Neo4j
See how connected feature extraction increases machine learning accuracy and precision
Walk through creating an ML workflow for link prediction combining Neo4j and Apache Spark

Quotation

Discover how graph algorithms help you leverage the relationships within your data to develop more intelligent solutions and enhance your machine learning models.
No comment yet.
Scooped by Mickael Ruau
December 15, 2021 1:54 AM
Scoop.it!

2 Ways to Make a UUID Generator for Postgres - DZone Database

2 Ways to Make a UUID Generator for Postgres - DZone Database | FrenchTech SAAS | Scoop.it
PostgreSQL allows you to store and compare UUID values, but it doesn't have any built-in methods for creating them. This is why this post was developed - to show you several ways to generate UUIDS in Postgres.
No comment yet.
Scooped by Mickael Ruau
December 12, 2021 8:55 AM
Scoop.it!

La Norme 32 est morte. Vive la norme 38 - Newsletter

La Norme 32 est morte. Vive la norme 38 - Newsletter | FrenchTech SAAS | Scoop.it
La Norme 32 est morte. Vive la norme 38…

En 1997, l’AFNOR avait créé une norme pour faciliter le traitement du courrier, son acheminement et les tarifs postaux pour des envois en nombre.

Par souci d’harmonisation européenne, une nouvelle norme est entrée en vigueur le 19 janvier 2013 et porte le doux nom de NF Z 10-011.

Cette nouvelle prendra définitivement la place de l’ancienne norme (les deux normes étant jusque-là gérées simultanément) à compter du 1er novembre 2015.

Ce qui change…

Le tri postal se fait de bas en haut. Donc du général vers le particulier. En conséquence, vous devez libeller vos adresses de la même façon : nom de la personne (Madame DENIS par exemple), complément d’informations d’un bâtiment (porte 2 par exemple), complément d’information dans la voie (bâtiment A par exemple), voie principale (2 rue de Paris), lieu-dit (Les Carrières par exemple), code postal/ville.
6 lignes au maximum sans ligne vierge.
38 caractères maximum par ligne, espaces compris. Un espace doit figurer entre chaque mot. Une abréviation n’est autorisée que lorsque le libellé de la voie dépasse 38 caractères.
No comment yet.
Scooped by Mickael Ruau
December 10, 2021 1:29 AM
Scoop.it!

Choose the Right Model: Comparing Relational, Document, and Graph Databases

Choose the Right Model: Comparing Relational, Document, and Graph Databases | FrenchTech SAAS | Scoop.it

There are 3 major types of database models in use today. In this post, learn about their differences and what applications for which they are best suited.

No comment yet.
Rescooped by Mickael Ruau from Time to Learn
December 9, 2021 4:21 AM
Scoop.it!

The Ultimate Google Sheets Toolkit

The Ultimate Google Sheets Toolkit | FrenchTech SAAS | Scoop.it
A curated list of Google Sheets resources to supercharge your analysis, manage your workflow, or build expertise in advanced analytics.

Via Frédéric DEBAILLEUL
No comment yet.