Your new post is loading...

|
Scooped by
Gilbert C FAURE
April 17, 3:07 AM
|
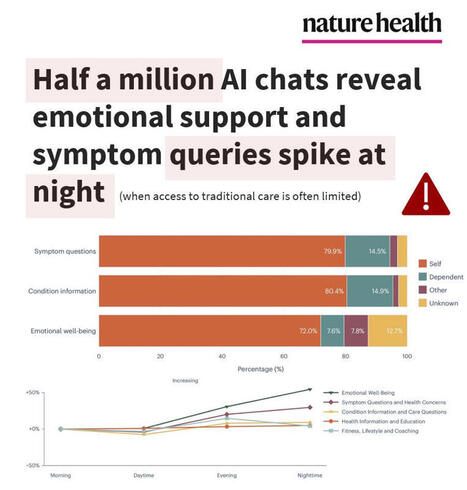
NEW STUDY🧨Half a million AI chats reveal emotional support and symptom queries spike at night, when access to traditional care is often limited.
What can Microsoft Copilot tell us from over HALF A MILLION (n = 617,827) de-identified health conversations?
-- Nearly 1 in 5 chatbot conversations involved personal symptoms, conditions, or test interpretation
-- About 1 in 7 personal health queries were about someone else (child, parent, partner)
-- Symptom queries happened mostly on mobile (15.9%) vs desktop (6.9%), whereas health-related research support was mostly on desktop (16.9%) vs mobile (5.3%)
-- Nighttime spikes on emotional support queries (from 3.3% morning to 5.2% nighttime) and symptoms/health concerns (from 10.6% morning to 13.4% nighttime)
These nighttime spikes (when healthcare access is most limited) may amplify user risk, as highly actionable LLM outputs are more likely to be relied on without professional support.
The authors did acknowledge safety RISKS in that mainstream AI models (ChatGPT, Google Gemini, Microsoft Copilot) may perform well on medical exams but NOT always on real-world emergency triage or decision-making, yet users keep turning to them for health advice and emotional coping.
The authors seem to take these risks seriously and concluded:
“From a safety perspective, the personal health intents identified here—such as symptom assessment, condition management and emotional well-being—arguably define categories in which the consequences of conversational AI responses are greatest and where investment in response quality and safety measures should be concentrated.”
Translation: we still have a long way to go and investment needs to be focused on the highest-risk use cases to make these models safe for public use, in a domain with near-zero tolerance for harmful errors.
Study in Nature Health linked below 👇 | 18 comments on LinkedIn
|
|
Scooped by
Gilbert C FAURE
March 11, 2:58 AM
|
Encore une publication de référence : la nouvelle édition du classement des applications d’IA générative les plus populaires (web et mobile).
➡️ ChatGPT toujours en tête, mais talonné par Gemini
➡️ De grosses disparités entre les pays occidentaux (US, UK, DE...)
➡️ Bcp d’usages autour de la génération d’images
https://lnkd.in/dk5Rank6 | 13 comments on LinkedIn
|
|
Scooped by
Gilbert C FAURE
December 8, 2025 4:25 AM
|
Day 23 - Process - #30DayMapChallenge
You see those red and blue “constellations” drawing themselves over Prague in Czech Republic?
This kind of map tells the story of a city through its flows, in the spirit of Erica Fischer’s design: a very subtle basemap, and mobility traces that become the real subject.
The idea is simple—let the data “write” the lived geography, here to compare walking vs. driving (or any other pair of modes) in Prague city center and its suburbs.
Practically, you start from anonymised mobility data (GPS traces from mobile apps or telecom operators), process and clean them for further contextual analytics.
Next comes behavioral analysis: map-matching the traces to the street network (OpenStreetMap), then classifying modes with algorithmic approach (speed, length, origin, distance to the segments, segments speciality, ....). This gives you “labeled” trajectories — here motors vehicules versus footfall —ready to layer on a map.
For the “Fischer-style” look, keep the background minimal (light gray, thin streets), then draw segments in semi-transparent layers with a short, high-contrast palette ( blue for cars, red for pedestrians).
For animation, you can progressively reveal trips in time slices (minute-by-minute or day-by-day accumulation), capture a video from your screen, and stitch them into a gif.
Source: CitiProfile
Tools: QGIS, FreeCam8, Gif Convertor
#30DayMapChallenge #mobilitydata #dataviz #gis #urbandata #walking
#transportation
|
|
Scooped by
Gilbert C FAURE
May 5, 2025 4:56 AM
|
SEO et IA : où en est-on vraiment ?
Chatbots IA : croissance record… mais les moteurs de recherche restent (pour l’instant) le réflexe numéro 1.
Entre avril 2024 et mars 2025, les dix plus gros chatbots ont engrangé 55,2 milliards de visites, en hausse de 80,9 % sur un an, alors que les dix plus gros moteurs de recherche ont perdu 0,5 %, mais totalisent toujours 1 863 milliards de visites. Autrement dit, les chatbots ne pèsent qu’environ 3 % du trafic « search ».
En mars 2025, un internaute consulte en moyenne 5,5 milliards de pages par jour via les moteurs, contre 233 millions via les chatbots : un ratio de 24 à 1 qui rappelle l’écart de puissance entre Google (4,7 Mds de visites quotidiennes) et ChatGPT (185 M).
Ce qui change déjà
• Les moteurs intègrent l’IA à grande vitesse : Google teste un mode « AI-only » sans liens bleus, propulsé par Gemini 2.0, et déploie ses AI Overviews dans plus de 100 pays.
• Les régulateurs s’en mêlent : le procès antitrust américain vise les accords par lesquels Google paie jusqu’à 20 milliards $/an pour rester le moteur par défaut, et l’usage de l’IA fait partie des griefs.
• Les éditeurs se rebiffent : Chegg a ouvert le bal des plaintes, accusant les résumés IA de « siphonner » son audience.
Trois scénarios plausibles à l’horizon 2026
1. Convergence : la page de résultats devient majoritairement générative. Le taux de clic organique chute, la visibilité dépend de la capacité à alimenter les modèles.
2. Fragmentation : des chatbots verticaux captent les requêtes spécialisées (voyage, B2B, éducation) ; le search conserve la longue traîne.
3. Choc réglementaire : si les accords par défaut tombent, Apple (ou un autre) lance son propre moteur, redistribuant 15-20 % du trafic mobile du jour au lendemain.
Comment se préparer dès maintenant
• Optimiser simultanément le SEO classique (schémas, liens) et les données structurées destinées aux réponses IA.
• Surveiller vos requêtes de marque : assurez-vous que les modèles disposent d’informations à jour (FAQ, fiches produit, pages « about »).
• Tester les chatbots côté service client pour aligner contenu et expérience conversationnelle.
• Garder un œil sur l’antitrust : la fin des deals par défaut ferait bouger le mix moteur plus vite qu’un nouvel algorithme.
En résumé : les chatbots n’enterrent pas la recherche ; ils transforment la façon dont elle se présente. Les gagnants seront ceux qui sauront jouer sur les deux tableaux – et pivoter si la réglementation bouleverse la donne. | 11 comments on LinkedIn

|
Suggested by
LIGHTING
January 30, 2023 9:55 AM
|
Download this game from Microsoft Store for Windows 10, Windows 8.1, Windows 10 Mobile, Windows Phone 8.1, Windows Phone 8. See screenshots, read the latest customer reviews, and compare ratings for Tap the Cat.
|
|
Suggested by
LIGHTING
May 15, 2021 12:16 PM
|
A mobile learning environment is about access to content, peers, experts, portfolio artifacts, credible sources, and previous thinking on relevant topics.
|
|
Suggested by
LIGHTING
May 12, 2021 5:23 AM
|
Le musée national des arts asiatiques - Guimet (MNAAG) situé dans le 16e arrondissement de Paris. Il conserve et expose l'une des plus riches collections d'art asiatique en Europe.
Le musée national des arts asiatiques - Guimet (MNAAG) situé dans le 16e arrondissement de Paris. Il conserve et expose l'une des plus riches collections d'art asiatique en Europe.. Paris. 37 Tracks. 89 Followers. Stream Tracks and Playlists from Musée Guimet on your desktop or mobile device.
|
|
Suggested by
LIGHTING
October 17, 2020 1:55 PM
|
Download this game from Microsoft Store for Windows 10, Windows 8.1, Windows 10 Mobile, Windows Phone 8.1, Windows Phone 8. See screenshots, read the latest customer reviews, and compare ratings for Tap the Cat.
Increasing access to information and communications technologies worldwide, along with the opportunities that they afford for learning and teaching, is changing the narratives of open and flexible learning. Two recent reports tracking the development of online and distance education in the United States suggest that while campus-based registrations are down overall, distance education enrolments are on the rise, with one in three students in the US higher education sector taking at least one online distance education course (Seaman, Allen, & Seaman, 2018; Legon, Gareett, & Fredericksen, 2019). This picture is not that dissimilar in other developed as well as many developing countries. For instance, recent surveys of student access to information and communications technologies at the University of the South Pacific, which has fourteen campuses on very small island states of the southwest Pacific region, show that around 80% of its students have access to mobile devices such as laptops and smartphones along with reliable access to the Internet (Jione, Fong, & Naidu, 2019). Availability of this kind of infrastructure means that a wider range of students from high school graduates to those who are working fulltime can have access to educational opportunities. It also means access to flexible learning opportunities, and a chance to upskill and reorient while still in employment. As a result, fewer and fewer students across the higher education sector, and around the world, are either studying or working at any one time. Instead, many are living their lives at the junction of multiple student identities, working and studying at the same time, and in search for a curriculum and qualification that will best meet their needs and career aspirations now and in the future. The implications of this kind of learning and teaching landscape for educational institutions are numerous. They include not only the need for an understanding of contemporary learners and their learning contexts but also the design of a curriculum and its suitability for the complex learning environment that they will inhabit in the future.
Via Edumorfosis, juandoming
|
|
Rescooped by
Gilbert C FAURE
from E-Learning-Inclusivo (Mashup)
December 8, 2019 10:35 AM
|
Spread the loveThe delivery of education has advanced over time as different technologies became available, and people’s lifestyles started to change. With the advent of computers and the internet, classes were no longer confined to a building, and distance learning became possible. With the advancement of technology, students received their learning materials via their computers and laptops, and eLearning came into being. The next development was mLearning, where students receive their learning materials on their mobile devices. There are several differences between these two forms of education. 1. Purpose eLearning aims to teach specific skills or deliver in-depth, comprehensive information …
Via Mariano Fernandez S., Juergen Wagner, juandoming
|
|
Rescooped by
Gilbert C FAURE
from Digital Delights for Learners
November 30, 2019 6:53 AM
|
MeetingMogul is a free conference calling app that brings a mobile-first approach to meetings. Try today to simplify conference calls on iPhone or Android.
Via Ana Cristina Pratas
|
|
Scooped by
Gilbert C FAURE
November 9, 2019 12:10 PM
|
This is the talk of the town. Explore the new PubMed, currently available at PubMed Labs for testing. It will be the default PubMed system in early 2020. Be ready for the questions that you know will come your way regarding this change. In this webinar you will preview the new, modern PubMed with its updated features including advanced search tools, saving citations to a Clipboard, options for sharing results, and the new "Cite" button. You'll also learn about the reasons for the change and how this new improved PubMed will make mobile searching easier.
|
|
Scooped by
Gilbert C FAURE
July 15, 2019 6:40 AM
|
learning, technology, education, steve, wheeler, social media, internet, mobile, school, teachers
|
|
|
Scooped by
Gilbert C FAURE
April 12, 3:44 AM
|
Kudos to the Pew Research Center team for writing the fantastic, in-depth report, "Where Do Americans Get Health Information, and What Do They Trust?" It will hopefully guide both consumer and industry decision-making as we all forge ahead into the latest health care revolution, this time powered by AI.
I smiled when I typed the word “revolution” just now. My very first report about health care and technology was published by Pew Research in the year 2000 and Lee Rainie and I had the audacity to title it, “The Online Health Care Revolution.” Twenty-four years later I published my book about the patient-led revolution in medical care, #RebelHealth. And now, two years later, I’m advising companies and organizations about how to harness AI for the greater good.
Looking back at how technology has changed the health information landscape, I see remarkable continuity:
🩺 People trust and turn to clinicians when they need help.
💡 There is always a small group of people pushing the capacity of new tools, whether mobile/social in the early 2000s or AI today. My tip: always look at what rare disease communities are doing. They are usually five to ten years ahead of the curve.
🎓 💰 Education, income, and health insurance status play big roles in how people gather health information.
What’s new in this week’s report: confirmation that peer-to-peer health advice is now mainstream.
In 2010, when I coined the phrase “peer-to-peer health care” we found that 18% of internet users had looked online for others with similar health concerns. The 2025 Edelman Trust Barometer reported that 67% of adults said personal experience with an issue is important when considering the legitimacy of a health information source – and that is particularly true among 18- to 34-year-olds. Now, in this week’s Pew Research survey we find that 66% of U.S. adults say they get health information at least sometimes from people with similar issues.
The technology keeps changing. The human need to find others who understand what you are going through never does.
What are you seeing in the health information landscape? What trends make you feel optimistic? Which worry you?
Reports linked below. Kudos to Giancarlo Pasquini, Galen Stocking, Emma Kikuchi, Isabelle Pula, Eileen Y. and the SSRS team, including Kristen Purcell. And for transparency, thanks to Claude for helping with the graphic below and reasoning through some of the thoughts I have about the last 25 years of health & tech. | 17 comments on LinkedIn
|
|
Scooped by
Gilbert C FAURE
December 10, 2025 7:05 AM
|
C’est une réponse cinglante aux modèles opaques et énergivores de la Silicon Valley et des répliques chinoises. Ce 9 décembre, l’hébergeur suisse infomaniak | The Ethical Cloud a dévoilé #Euria, son propre #assistant d’#intelligenceartificielle. Accessible gratuitement sur mobile et le Web, Euria ne se contente pas de rivaliser avec ChatGPT sur le plan des fonctionnalités : elle introduit un modèle vertueux (inédit) où chaque requête contribue à chauffer des foyers à Genève, tout en garantissant qu’aucune donnée personnelle ne sert à l’entraînement des modèles. Ah oui, c’est open source !
Source : Goodtech ( ex-TOOLINUX)
#Infomaniak | 18 comments on LinkedIn
|
|
Scooped by
Gilbert C FAURE
October 4, 2025 5:52 AM
|
18% des médias et 33% des sites tech les plus recommandés par Google sont générés par IA De « Don't be evil » à « Je danse le mIA » L'algorithme Discover de « recommandation de contenus » de Google, principale source de trafic des sites journalistiques français, est devenu une « pompe à fric » pour les sites monétisés par la publicité, majoritairement financés par... la régie publicitaire de Google. Au point que près de 20 % des 1 000 sites d'info les plus recommandés par Google Discover, et 33 % des 120 sites les plus recommandés par Google News, à la rubrique Technologie, sont générés par IA. Jean-Marc Manach Le 03 octobre à 13h24 27 min IA et algorithmes Dans la mesure où la lutte contre la désinformation nous semble un enjeu de salubrité (numérique) publique, cet article, en principe réservé aux lecteurs premium de Next, est exceptionnellement en accès libre pour 24 heures. Ce sont vos abonnements qui rendent possible ce genre d'enquête au long cours, merci ! En 2024, et pour la deuxième année consécutive, le trafic en provenance de l'algorithme de recommandation de contenus Discover de Google avait explosé de + 50%. Au point d'être devenu la principale source de trafic pour la presse française, avec plus de 500 millions de clics vers des articles de presse par mois, selon le baromètre de la diffusion 2024 de l’Alliance pour la presse d’information générale (APIG). 61 % du trafic des sites d'infos émane en effet de Google, et 68 % de ce trafic émane de Discover, rendant les sites de presse « dépendants » de cet algorithme. Une véritable « pompe à fric » qui attire de nombreux professionnels du marketing numérique, du référencement et du « black hat » SEO, cherchant eux aussi à profiter de cette manne publicitaire, monétisée par... Google via sa régie AdSense. Une tendance qui ne semble pas prête de s'infléchir, bien au contraire, comme notre enquête au long cours le documente depuis des mois. D'autant que Google a aussi récemment annoncé que Discover serait prochainement disponible en mode « desktop ». Ce qui ne pourra qu'augmenter le trafic des sites qui y sont recommandés, mais également l'appétit des éditeurs de sites GenAI qui voudraient eux aussi pouvoir « poper » sur Discover, pour reprendre l'expression consacrée. [Récap] Nous avons découvert des milliers de sites d'info générés par IA : tous nos articles Perdu dans le jargon ? Petit lexique pour s’y retrouver Discover : la mission historique de Google est d’amener des réponses aux requêtes des internautes, mais le moteur développe depuis des années des outils de recommandation, qui sélectionnent automatiquement des contenus et les affichent aux utilisateurs de Google, de Chrome et d’Android. Sur mobile, les suggestions Discover sont par exemple visibles dès l’interface du système d’exploitation. Elles sont devenues la principale source de trafic des médias français. Poper : de l’anglais to pop, qui signifie sauter ou éclater. Ce terme est utilisé par les professionnels du référencement pour désigner la capacité à faire apparaitre un site ou un contenu donné au sein des outils de recommandation automatisés. SEO : de l’anglais search engine optimization, soit optimisation pour les moteurs de recherche. Le terme recouvre à la fois les pratiques techniques ou éditoriales visant à favoriser l’apparition d’un site dans les moteurs de recherche, et l’activité de service qui s’est créée autour de cet objectif. 7 700 articles en 15 jours, soit plus de 510 articles par jour, tout seul Début août, l'éditeur de Gnewsalyzer, un outil d'analyse du trafic de Google News et Discover, annonçait sur X.com qu'il était désormais possible d'y « visualiser les sites qui viennent de rentrer sur Discover depuis moins de 10 jours et qui performent ». En réponse, son prédécesseur et concurrent (payant) 1492.vision rétorqua qu'il proposait lui aussi une fonctionnalité similaire. Or, ces nouveaux sites récemment apparus sur Discover et figurant sur leurs captures d'écran respectives ont tous pour point commun d'être générés par IA (GenAI) – à l'exception des quatre sites n'ayant été recommandés que trois fois sur le screen de Gnewsalyzer. Le créateur de Gnewsalyzer, Clément Pessaux, estimait cet été qu'il parvenait à récupérer de 10 à 20 % des 15 000 articles qui seraient chaque jour recommandés par Discover en français, sans que nous ayons pu vérifier ces chiffres de manière indépendante, non plus que via Google. La base de données de Gnewsalyzer comporterait à ce jour plus de 6 800 sites, dont 1 000 environ ont été recommandés une dizaine de fois au moins par Discover. Des chiffres qui, à défaut d'être exhaustifs – et probablement minorés pour ce qui est du nombre d'articles réellement recommandés – n'en constituent pas moins un échantillon somme toute représentatif des sites francophones recommandés par Google. À l'époque, le site qui surperformait sur Discover, decontair-67.fr, y avait à lui seul été recommandé au moins 325 fois en seulement 7 jours (soit 46 fois par jour, en moyenne). Au total, d'après le dashboard de Gnewsalyzer, Discover recommanda 614 de ses articles (au moins) avant qu'il n'en disparaisse, 12 jours après y être apparu la première fois, vraisemblablement pénalisé par Google pour avoir spammé son algorithme, et donc violé ses conditions d'utilisation. Il est somme toute improbable qu'un média qui serait composé de journalistes puisse choisir un nom de domaine aussi imbitable et un logo aussi ridicule pour se mettre soudainement à publier autant d'articles en aussi peu de temps, a fortiori entre le 1er et le 13 août. Et ce, pour y publier des titres de cinq lignes relayant des informations abracadabrantesques et illustrées par des images générées par IA croquignolesques, comme cette piscine gonflable remplie par (et avec) des « bouteilles » d'eau minérale, ou cette autre « piscine à glaçons » offerte par un refuge pour chiens et accusée de « gaspillage d'eau potable ». Comme c'est quasiment toujours le cas avec les sites GenAI, decontair-67.fr est un nom de domaine expiré, ayant appartenu précédemment à une entreprise de désamiantage de Strasbourg, et racheté par le spammeur. La question reste de savoir pourquoi l'algorithme de Google l'a recommandé ces 614 fois (au moins), mais également pourquoi ses filtres antispam ont mis 15 jours avant de le mettre en quarantaine. Au-delà des articles publiés sur le site (rien n'interdit de publier du « bullshit », ni d'opter pour des titres « putaclics »), ceux qui furent recommandés par Discover étaient pourtant sujets à caution. Il y était par exemple question d'un retraité sanctionné « pour avoir réparé bénévolement les vélos des enfants du quartier », de familles verbalisées pour avoir improvisé des cabanes sur la plage avec des draps mouillés, ou encore d'un « lac souterrain gigantesque » découvert sous le désert du Sahara et qui « pourrait alimenter toute une région ». Son successeur, amios.fr, a fait encore plus fort. Apparu sur Discover le 13 août, il a réussi à y faire « poper » au moins 1 608 articles avant d'en être exclu le 28, soit une moyenne de 107 articles par jour. Là encore, les titres des articles surfaient sur la peur, avec par exemple plus de quarante articles déclinant le fait que « les requins prolifèrent à cause du réchauffement », que les « les scientifiques préviennent que les plages sont devenues des zones de chasse », ou encore qu' « un expert dit que les vacanciers sont littéralement sacrifiés », eux aussi illustrés par d'improbables images générées par IA. Dix de ces articles n'en ont pas moins été recommandés par Discover. Pour parvenir à ce que l'outil de suggestion de contenus de Google relaie ces 1 608 articles, amios.fr en a publié plus de 7 700 (soit plus de 510 par jour, en moyenne), d'après une sauvegarde de son sitemap sur archive.org. Signe de la montée en puissance du spammeur, et à titre de comparaison, decontair-67.fr n'en avait publié qu'un peu plus de 2 300 (soit 192 par jour) sur une période équivalente. La moitié des sites GenAI émane d'un seul serial éditeur... Début septembre, sur les 30 sites apparus sur Discover ces 10 derniers jours et y ayant été recommandés au moins 4 ou 5 fois, 27 étaient des sites générés par IA (soit 90 %), dont 17 (soit plus de la moitié) appartiennent à la ferme de contenus (« content farm », ou « private blog network » – PBN) de sites GenAI de Julien Jimenez, l'éditeur de decontair-67.fr et amios.fr. Nous avions consacré un article à ce serial-spammeur de sites GenAI, début juillet, après que d'autres pros du marketing numérique et du référencement (pourtant eux-mêmes éditeurs de sites GenAI), se furent publiquement plaints du volume de spams qu'il envoyait à Discover, au risque d'attirer l'attention de Google sur leur juteux business. Éditeur de sites générés par IA, il spamme tellement Google que ses confrères se plaignent Dans un précédent article, nous avions aussi relevé que plusieurs éditeurs de sites GenAI comparaient Discover aux recommandations algorithmiques « addictives » de TikTok, mais également à une « une drogue » susceptible de « générer une dépendance », au vu des centaines voire milliers d'euros de chiffre d'affaires susceptibles d'être engrangés, par jour. Deux d'entre eux seraient même devenus millionnaires grâce à Discover, en trois mois seulement. Sites d’infos générés par IA : « Notre job, c’est gruger Google » pour faire du fric Mais pour espérer pouvoir « poper » sur Discover, il faut publier. Le 10 juillet dernier, labottega-pinseria.fr, l'un des sites de la ferme Jimenez, avait par exemple publié 760 articles entre 9h03 et 10h03, soit plus de douze articles... par minute. Au vu de cette hyperproductivité automatisée et humainement impossible à valider, ses articles « hallucinent » régulièrement de nombreuses infox', elles aussi considérées comme nuisibles à la profession par de nombreux éditeurs de sites GenAI, au motif qu'elles pourraient inciter Google à faire le ménage. Au point que l'un de ses concurrents l'avait qualifié de « maître de la désinformation via une diffusion industrielle de fake news sur ses propres réseaux de sites ». Julien Jimenez avait déjà attiré l'attention de plusieurs journalistes et rédactions pour avoir publié de nombreux articles au sujet de prétendues fermetures de magasins ayant, dans certains cas, affolé clients, syndicats et employés. Il est l'un d'ailleurs l'un des rares éditeurs de sites GenAI dont le nom a été rendu public, et à avoir vu plusieurs de ses articles faire l'objet de fact-checks, comme l'avait souligné en juillet l'ONG Reporters sans frontières, déplorant que Google Discover soit « désormais infiltrée par des sites aux titres aguicheurs, aux informations douteuses ou totalement fausses ». ... qui écrase Ouest France, Le Parisien, BFM et L'Équipe Nous n'avons pas calculé le nombre d'articles publiés chaque jour par chacun des 17 sites de Jimenez figurant dans ce Top30, mais on peut raisonnablement estimer, au vu des statistiques de decontair-67.fr et amios.fr, qu'il en publie probablement plusieurs milliers par jour, sans relecture, ni validation. Et ce, alors qu'il est par ailleurs parti faire un tour du monde en famille début août, et qu'il ne travaillerait qu'à temps partiel, le matin. L'échantillon d'articles promus sur Discover qu'a recueilli Gnewsalyzer montre que, certains jours, Discover a recommandé jusqu'à 196 articles d'amios.fr, soit deux fois plus que les 94 articles de ouest-france.fr, six fois plus que la trentaine d'articles du Parisien, L'équipe et BFM, et 10 fois plus que les 19 articles du Figaro. Discover a également recommandé, en 15 jours seulement, deux fois plus d'articles d'amios.fr que ce qu'actu.fr, lequipe.fr, lefigaro.fr et leparisien.fr y ont vu « poper » en 30 jours. Une surproduction sous stéroïdes, générée grâce à l'IA par un professionnel du marketing solitaire (et travaillant à mi-temps), qu'aucune rédaction composée de journalistes humains ne saurait pouvoir effectuer. Mais que l'algorithme Discover de Google n'en « recommande » pas moins à ses lecteurs et utilisateurs. Le graphique montre par ailleurs que, si amios.fr a disparu de Discover le 28 août, vraisemblablement suite à une pénalité de Google, il a tout de suite été remplacé, le même jour, par un autre site de la ferme de sites GenAI de Jimenez, couteauduviaur.fr, et que ce dernier surperformait tous les autres sites d'info trois jours plus tard seulement. 33 % des sites les plus recommandés sur Google News Technologies sont GenAI D'après le spécialiste des noms de domaine David Chelly, les sites GenAI de Julien Jimenez lui permettraient d'engranger « à peu près de 100 000 à 150 000 euros de revenus par mois », rémunéré « essentiellement par AdSense » (la régie publicitaire de Google), grâce à un « trafic incroyable », du fait que « les fake news, c'est le meilleur moyen » de créer du buzz et de générer du clic. Une estimation impossible à vérifier, mais qui a été corroborée par l'une de nos sources bien informées. Or, ce « trafic incroyable », et les revenus associés, correspondent également à autant de pertes de trafic et de revenus pour les médias reposant sur le travail de journalistes professionnels qui, contrairement à la ligne éditoriale que semble privilégier Julien Jimenez, ont à cœur de ne surtout pas publier d'infox'. Pour autant, si ses sites surperforment, il n'est pas le seul « black hat SEO », loin de là, à faire mieux que de nombreux médias et sites de presse, et donc à cannibaliser le travail des journalistes. Mi-août, Gnewsalyzer répertoriait en effet un peu moins de 4 300 noms de domaine différents (certains y figurent en doublons, faussant ses stats). Or, nous avons découvert qu'environ 400 d'entre eux au moins (soit un peu plus de 9 %) figuraient dans notre liste d'un peu plus de 7 000 sites d'info générés par IA. Téléchargez notre extension web (gratuite) pour être alerté lorsque vous visitez un site d'info généré par IA Nous avons développé une extension pour les navigateurs Chrome (et donc Brave, Vivaldi, Opera, Microsoft Edge, etc.) et Firefox (y compris en version mobile sur Android), qui tourne en tâche de fond et affiche un pop-up d'alerte lorsque ses utilisateurs consultent un des 7 000 sites d'information dont nous avons identifiés que leurs contenus sont en tout ou partie générés par des intelligences artificielles génératives. Afin de vous prémunir des autres risques de cyberarnaques, notre extension prend également en compte deux autres listes : celle de plus de 30 000 noms de domaine « suspects » de Red Flag Domain, ainsi que la liste noire des entités non autorisées à proposer des produits ou services financiers en France de l’Autorité des marchés financiers (AMF). Télécharger notre extension sur Firefox Télécharger notre extension sur Chrome À défaut de pouvoir vérifier (faute de temps) l'intégralité de ces 4 300 noms de domaine, nous avons cela dit vérifié les 1 016 sites ayant été recommandés par Discover au moins 10 fois, et découvert que 184 figuraient dans notre base de données de sites générés par IA, soit plus de 18 %. Nous avions de fait déjà découvert, en juin, via le Top 50 de DiscoverSnoop.com, que 14 % des 50 sites les plus mis en avant sur Discover France étaient générés par IA. Depuis janvier, plus de 15 sites GenAI y ont figuré, dont 1 pendant 5 mois, 3 pendant 3 mois, 2 pendant 2 mois, & 4 dans son Top25 (dont un pendant 3 mois consécutifs, un autre 2 mois de suite) – quand bien même certains d'entre eux avaient pourtant été signalés comme tels à Google –, signe que nombre de sites GenAI ne sont pas, contrairement à ceux de Julien Jimenez, identifiés comme tels et sanctionnés au bout de 15 jours. Et ce, alors que Google n'a de cesse de répéter, depuis des mois, que ses « systèmes antispams » excluent « 99 % [...] des contenus de faible qualité », comme il vient encore de le répéter au Monde. Les statistiques de Gnewsalyzer indiquent par ailleurs que, sur les 120 sites les plus recommandés dans la rubrique technologie de Google News, 40 (soit 33 %) sont générés par IA. Ce qui ne semble pas être le cas des autres verticales thématiques, telles que Gnewsalyzer les a indexées. Nous sommes conscients que son dashboard n'analyse qu'une partie des articles recommandés par Google, mais cette surreprésentation des sites GenAI n'en relève pas moins une tendance préoccupante. « Je ne suis pas journaliste, chacun son métier » En réponse à la publication en février dernier de nos premiers articles sur cette pollution de sites GenAI, Clément Pessaux (qui n'avait pas encore lancé Gnewsalyzer) avait publié une tribune libre en défense des éditeurs de sites GenAI, qualifiant de « dangereux ce discours qui pose le journalisme comme gardien du temple de certaines vérités ». Pionnier de l'édition de sites GenAI, Pessaux figure aussi parmi les cofondateurs de Discover Partners, qui se vante de pouvoir décupler le trafic des sites grâce à Discover et d'avoir contribué à générer « plus de 700 millions de visites… dans + de 30 pays différents [et] jusqu'à 5 millions de visiteurs par jour ». Lui-même éditeur de sites GenAI, nous l'avions également interviewé après que l'un de ses sites ait repris une infox, émanant de sites générés par IA, qui avait pourtant été fact-checkée et démentie entre-temps. « Je ne suis pas journaliste, chacun son métier », nous avait-il rétorqué : « Quelque part, la matière informative ne m'intéresse pas, c'est de la matière que je sculpte, ce qui m'intéresse c'est comment Google la perçoit, puis après comment la masse des lecteurs la perçoit, pour que l'info soit appréciée de Google et du lecteur. » Cette « rumeur » relayée par de nombreux médias émanait de sites générés par IA Dans une autre vidéo, il reconnaissait par ailleurs que Discover « génère une dépendance, c'est une drogue, il faut le dire, parce que ça génère pas mal d'argent, et quand t'es là-dedans ça devient difficile de lâcher prise, tu deviens mégalo avec ça » : « Le problème avec Discover, c'est que ça génère énormément d'adrénaline : quand tu as un site qui commence à faire 100 00 ou 200 000 visites par jour, avec 10 000 visiteurs en simultané qui génère entre 200 à 500 euros par jour, multipliés par 30 ça fait 15 000 euros… » Sites d’infos générés par IA : « Notre job, c’est gruger Google » pour faire du fric La publication massive de fake news sur Discover, un « véritable succès d'audience » Dans une vidéo qu'il vient de mettre en ligne afin d'expliquer comment Gnewsalyzer pouvait aider d'autres éditeurs à « performer » sur Discover, Clément Pessaux qualifie lui-même les sites de Jimenez de « spammeurs », relève qu'ils « ont une durée de vie de 3 semaines, 15 jours 3 semaines, pas plus », mais recommande néanmoins de s'en inspirer : « Comme toujours avec le SEO en général, ce qui nous intéresse le plus à étudier c'est les sites qui sont "border" qui vont prendre les stratégies les plus avancées, les plus à la marge on va dire, pour pouvoir les adapter à nos propres sites de manière beaucoup plus safe et pérenne. » Gnewsalyzer a en effet été conçu pour aider les éditeurs de sites à « révolutionner [leur] stratégie Google Discover », notamment grâce à un « espionnage intelligent de la concurrence » afin d' « analyser les stratégies des sites les plus performants, y compris ceux aux méthodes "borderline" qui constituent pourtant une mine d'or d'informations sur les titres accrocheurs et les typologies d'images qui fonctionnent ». Des éditeurs de sites GenAI se vantent d'ailleurs déjà d'y avoir identifié des patterns leur permettant de surperformer. Contacté pour savoir comment il expliquait cette surreprésentation des sites GenAI, Clément Pessaux nous répond que « Discover est basé sur Navboost, un algorithme qui mesure avant tout le niveau d’interaction des utilisateurs sur une page : clics, temps de lecture, partages, etc. », et que « les contenus qui performent le plus sont ceux qui intéressent et engagent réellement les lecteurs » : « Ce n’est donc pas une histoire de "GenAI ou pas GenAI" : c’est une histoire d’adéquation entre l’offre éditoriale et les attentes de l’audience. Tant que certains journalistes continueront à écrire avant tout pour eux-mêmes, sans prendre en compte les formats, les angles, les temporalités ou les sujets qui captent l’attention des lecteurs, ils laisseront mécaniquement la place à ceux qui savent écouter et répondre à cette demande. Les médias traditionnels ont deux options : rester dans un modèle qui ne parle plus aux audiences Discover, ou adapter leurs formats pour exister dans un écosystème qui pèse des millions de lecteurs par jour. » Interrogé sur la surreprésentation des sites GenAI de Julien Jimenez, les nombreuses infox' qu'ils relaient, le fait que, faute de respecter les règles de Google, ils sont généralement pénalisés au bout de 15 jours à trois semaines, Clément Pessaux élude nos questions et, relancé, refuse d'y répondre : « Je n'ai rien à dire sur le sujet aujourd'hui, strictement rien ». « Dans le cas des dernières pénalités, il s'agit de sites qui ont clairement dérivé vers la publication massive de fake news pour faire le buzz et capter du trafic, avec un véritable succès d'audience », avait-il cela dit répondu au Journal du Net, soulignant que « ces sites sont devenus très visibles, attirant ainsi l'attention de tous, y compris de Google, qui a décidé de les exclure de Discover » : « C'est toute la problématique de Discover aujourd'hui. Une très petite minorité de sites pousse le curseur trop loin, dégradant par amalgames et raccourcis l'image globale de Discover. Les équipes de Google en sont parfaitement conscientes, c'est pourquoi on peut observer, par vagues, des pénalités manuelles tomber. » Contacté, Julien Jimenez, qui a jusqu'alors systématiquement refusé de répondre aux sollicitations de journalistes, ne nous a pas non plus répondu. Des infox' GenAI en « Une » de Google Discover Notre enquête avait déjà démontré que Google ne respecte pas ses propres règles. Elles stipulent en effet que, pour pouvoir être indexés, les contenus mis en ligne doivent respecter ses critères EEAT (pour « Expertise, Experience, Authoritativeness, Trustworthiness », ou « Expertise, Expérience, Autorité, Fiabilité » en français). Les sites et articles GenAI que nous avons identifiés, qui semblent majoritairement ne pas avoir été relus avant d'être publiés, « en masse », ne devraient dès lors pas pouvoir figurer dans les résultats de son moteur de recherche, encore moins de Google Actualités, et ne sauraient non plus être « recommandés » par son algorithme Discover de « recommandation » de contenus. Un problème de filtrage et de modération d'autant plus étonnant que, lorsque Google avait été confronté à une déferlante de publicités reposant sur l'usurpation d'identité de « people » et personnalités, générée par IA, afin de promouvoir des escroqueries, la régie publicitaire de Google avait « rapidement constitué une équipe de plus de 100 experts », et suspendu « plus de 700 000 comptes d'annonceurs », comme nous l'avions relevé. Google pénalise les publicités générées par IA (mais pas les médias générés par IA) Une célérité que Google ne semble pas avoir mise en œuvre pour ce qui est des contenus « générés par IA » recommandés par son algorithme Discover qui, comme nous l'avons aussi documenté, sont par ailleurs majoritairement monétisés par AdSense, la régie publicitaire de Google. Contacté, Google nous répond que « bien que l'utilisation de l'automatisation, y compris l'IA, pour générer du contenu dans le but principal de manipuler le classement dans les résultats de recherche constitue une violation de nos règles relatives au spam, toute utilisation de l'automatisation, y compris la génération par IA, n'est pas considérée comme du spam (voir plus ici) » : « Nous nous engageons à proposer des contenus utiles et de haute qualité dans Google Discover, et nos règles interdisent formellement les contenus trompeurs, manipulés ou mensongers. Nos systèmes automatisés sont très efficaces pour appliquer ces règles à grande échelle. Par exemple, comme nous l'avons mentionné, nos systèmes anti-spam maintiennent les résultats de la recherche Google à plus de 99 % exempts de spam. » Contacté par Le Parisien, à qui nous avons partagé notre enquête, Google précise que « les analyses de Next reposent sur des outils tiers qui ne sont pas directement connectées aux données de Google, ne sont pas représentatives de l’écosystème Discover ». Il suffit pourtant de consulter la liste (.pdf) des 1 000 sites les plus recommandés par Discover sur Gnewsalyzer pour constater que l'échantillon est bien représentatif de l'écosystème médiatique français, et que quatre des sites GenAI de Jimenez figurent dans son Top120. Notre enquête montre bien que les sites d'info GenAI de Julien Jimenez « surperforment » les principaux médias français sur Discover – quand bien même ces derniers reposent sur le travail de centaines de journalistes, alors que Jimenez travaille seul et à mi-temps –, et qu'ils ne sont, au mieux, déréférencés qu'au bout de 15 jours à trois semaines seulement – quand bien même ils violent pourtant les règles de Google. Les sites GenAI sont en outre « sur-représentés » par rapport aux sites d'information – au point de représenter près de 20 % des sites les plus « recommandés », et que le tiers des 120 sites les plus recommandés par Google News, à la rubrique Technologie, sont générés par IA. Les « éléments de langage » répétés à l'envi depuis des mois par Google sont également contredits par les centaines de captures d'écran que nous accumulons depuis des mois (à partir d'un profil non connecté, pour limiter le profiling associé), les infox GenAI allant jusqu'à figurer à la « Une » et donc en tête des recommandations de Google Discover, comme l'attestent ces quelques captures d'écran, extraites de nos archives. Il nous est par ailleurs plusieurs fois arrivé de découvrir, dans la quinzaine de contenus recommandés par Discover, que trois, quatre voire cinq articles (soit de 20 à 33 %) émanaient de sites d'infos générés par IA... signe que Google ne parvient pas à filtrer « 99 % » du spam, mais également que « l’EEAT semblerait ne pas avoir l’importance que l’on peut penser », comme l'avaient relevé Abondance et d'autres au sujet de son algorithme de « prédiction » Navboost, conçu pour améliorer les résultats de recherche en se basant sur les interactions des utilisateurs avec les pages de résultats de recherche. « Google ne dit pas la vérité » Mi-juillet, Vincent Berthier, responsable du bureau technologies et journalisme de RSF, avait appelé Google à « renforcer ces critères de sélection, ainsi que le contrôle de leur respect, avant que les utilisateurs ne soient submergés par les fausses informations déroulées à la chaîne par ces rotatives numériques » : « La facilité avec laquelle des sites peu recommandables parviennent à se hisser dans Discover pousse à s’interroger sur les failles de ce service. Il devient urgent de les combler en remaniant son fonctionnement, et d’empêcher la promotion des faux sites d’information. Les bloquer manuellement ne suffira pas : ce sont des hydres. » Virginie Clève, bien connue dans le monde des médias pour son expertise en matière de marketing numérique et donc de SEO, invite les éditeurs de presse à porter plainte, « tous les mois s'il le faut ». Elle estime en effet que « Google ne dit pas la vérité », alors qu'« en termes de réputation, c'est catastrophique d'être responsable d'une telle dispersion de contenus pourris, anxiogènes, faux, fracturant la société ou contribuant à sa déstabilisation ». Pour elle, Google « ne fait rien » parce que le problème concerne principalement la France (du fait que « les spammeurs SEO FR sont parmi les plus doués au monde »), et peu leur marché domestique états-uniens, ce pourquoi Google minimiserait l'ampleur de cette pollution. Elle estime également que le fait de renforcer l'antispam de Discover ne serait pas prioritaire, alors que stratégiquement les moyens sont mis ailleurs, en particulier sur l'IA, et que « cela ne gène en rien l'audience et l'adoption du produit, sans doute même l'inverse ». Face à cette épidémie d'infox, Google... invisibilise le fact-checking Sur sa page « Notre approche de la recherche », Google indique que sa mission est « d'organiser les informations à l'échelle mondiale dans le but de les rendre accessibles et utiles à tous ». Or, Google a récemment annoncé – sans prévenir les rédactions concernées – la fin de l’affichage des balises ClaimReview qui rendaient visibles les articles de fact-checking dans son moteur de recherche depuis 2017, comme CheckNews l'a relevé. En outre, la déferlante de contenus générés par IA est telle que les plateformes et réseaux sociaux sont eux aussi submergés de contenus GenAI, qu'il s'agisse de YouTube, Instagram, TikTok, Facebook et même LinkedIn, comme le relatait l'épisode de Last Week Tonight with John Oliver consacré cet été à l'« AI slop », du surnom donné à ces contenus bas de gamme générés par IA. Plus de 7 000 sites d'info GenAI, mais jusqu'à quand ? Cet article est l'occasion de rappeler que l'extension (gratuite) pour les navigateurs Firefox et Chrome, développée par Next afin d'afficher un message d'alerte lorsque ses utilisateurs visitent un site d'info généré par IA, a franchi le cap des 6 000 sites cet été, et des 7 000 sites peu après la rentrée. Alerte sur les sites GenAI : notre extension signale plus de 6 000 sites et passe en v2.3 Elle permet par ailleurs à ses utilisateurs de nous envoyer un message lorsqu'ils estiment avoir identifié un site d'info GenAI, et nous avons rajouté, en août, la possibilité d'y associer votre adresse mail, de sorte de pouvoir vous répondre ou en discuter, au besoin. Depuis son lancement, début février, nous avons ainsi reçu plus de 1 500 signalements de la part de ses utilisateurs. Ces alertes nous ont permis d'identifier plusieurs fermes de contenus de dizaines voire centaines de sites, et de nombreux sites GenAI que nous n'avions pas encore détectés, ou qui ont récemment été mis en ligne. Nous tenions donc à vous en remercier. PS : nous n'y répertorions que les seuls sites d'information/actu/médias, pas les sites GenAI type ChatGPT & Cie. Les chatbots d'IA génératives peuvent être utiles, du moment où ils sont utilisés à bon escient, en en comprenant les limites, et problèmes associés. Les sites d'infos GenAI, par contre, ne sauraient en l'état être considérés comme fiables, nonobstant le fait que leur objectif n'est pas d'informer. 18% des médias et 33% des sites tech les plus recommandés par Google sont générés par IA Perdu dans le jargon ? Petit lexique pour s’y retrouver 7 700 articles en 15 jours, soit plus de 510 articles par jour, tout seul La moitié des sites GenAI émane d'un seul serial éditeur... ... qui écrase Ouest France, Le Parisien, BFM et L'Équipe 33 % des sites les plus recommandés sur Google News Technologies sont GenAI Téléchargez notre extension web (gratuite) pour être alerté lorsque vous visitez un site d'info généré par IA « Je ne suis pas journaliste, chacun son métier » La publication massive de fake news sur Discover, un « véritable succès d'audience » Des infox' GenAI en « Une » de Google Discover « Google ne dit pas la vérité » Face à cette épidémie d'infox, Google... invisibilise le fact-checking Plus de 7 000 sites d'info GenAI, mais jusqu'à quand ? Commentaires 10
|
|
Rescooped by
Gilbert C FAURE
from E-Learning-Inclusivo (Mashup)
January 12, 2024 2:38 AM
|
"Microlearning in the Digital Age explores the design and implementation of bite-sized learning and training in technology-enabled environments. Grounded in research-based best practices and a robust, eight-dimensional framework, this book applies the latest developments in mobile learning, social media, and instructional/multimedia design to one of today’s most innovative and accessible content delivery systems. Featuring experts from higher education, information technology, digital gaming, corporate, and other contexts, this comprehensive guide will prepare graduate students, researchers, and professionals of instructional design, e-learning, and distance education to develop engaging, cost-effective microlearning systems."
Via EDTECH@UTRGV
|
|
Scooped by
Gilbert C FAURE
May 14, 2021 4:37 AM
|
search and get pdf link now ; improved web interface and browser tools for searching and viewing biomedical articles ; Fast, Light & Mobile Friendly...
How blockchain can help
The report explains how blockchain technology can be used to generate and store sensitive personal records online or on mobile apps - such as birth certificates, driving licences or professional qualifications - for instant proof of identification. Universities can create degree certificates that can be shared by graduates with prospective employers at the touch of a button. They can be instantly verified, with no need to run a credentials check with a third party. It frees us all from the time-consuming, inefficient, paper-based credentials system, saving time and money, improving efficiencies and helping to eliminate fraud.
These systems are already in use. Here at PwC, we have partnered with, among others, the Institute of Chartered Accountants and a major European university to develop our Smart Credentials blockchain platform. It shares the credentials of chartered accountants and technology graduates in a ‘digital wallet’, saving a huge amount of time and money in the verification process, while combating fraud. Students can also add any number of documents to it, from their birth certificates to a sporting qualification, which they can control and share. Going forward, we plan to scale our experience of Smart Credentials in a deeper transformational context, working with aligned service providers covering technology and resourcing, to build what is effectively an internet of credentials. Learn more / En savoir plus / Mehr erfahren: https://www.scoop.it/t/21st-century-learning-and-teaching/?&tag=blockchain
Via Gust MEES
|
|
Rescooped by
Gilbert C FAURE
from E-Learning-Inclusivo (Mashup)
October 14, 2020 6:36 AM
|
Le marché mondial du Mobile Learning est attendu en croissance de 13% par an entre 2020 et 2026, de 20 milliards à 55 milliards de dollars, selon l’étude Global Market Insights qui vient de sortir.
Via Doc-Ifsi-Narbonne, juandoming
|
|
Scooped by
Gilbert C FAURE
December 21, 2019 5:29 AM
|
Découvrez Seekoya'Cards : notre plateforme web et son application mobile de microlearning. Créer son app de microlearning pour ses apprenants : c'est simple
|
|
Scooped by
Gilbert C FAURE
December 6, 2019 1:09 PM
|
learning, technology, education, steve, wheeler, social media, internet, mobile, school, teachers
|
|
Rescooped by
Gilbert C FAURE
from E-Learning-Inclusivo (Mashup)
November 8, 2019 11:46 AM
|
ePedagogy might broadly be defined as ‘learning design that incorporates educational quality, values and effectiveness of teaching, learning and assessment activities supported by technology’. On the one hand, one might argue against a separation of ‘e’ pedagogy from any other pedagogy. On the other hand, research and evaluation literature suggests that new modes of teaching and learning are emerging through the use of online networks, access to remote experts and, more recently, mobile technologies. This article outlines trends in thinking in learning and teaching at Warwick and presents a number of issues, presuppositions and questions about appropriate pedagogies for developing e-learning at Warwick.
Using a “review and respond” approach to a draft of this article, a number of staff across the University were asked for their views on the issues of appropriate pedagogical models for developing e-learning at Warwick. Their comments are presented alongside the questions posed in the article.
Via Edumorfosis, juandoming
|